- 25 May, 2026
UTM, referrers et trafic direct : lire correctement vos sources d’acquisition
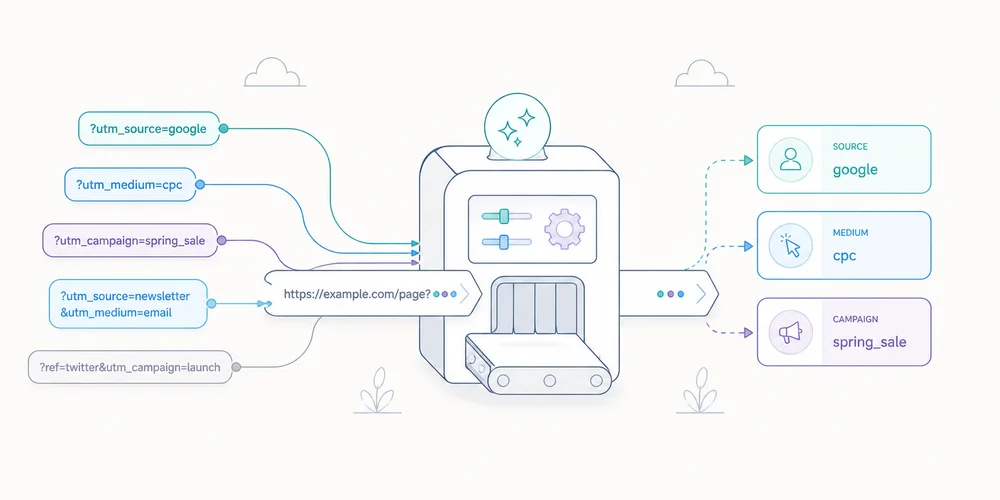
Une hausse du trafic direct ne signifie pas forcément que davantage de personnes tapent spontanément votre adresse dans leur navigateur. Une campagne marquée avec des UTM ne dit pas toujours qui a réellement influencé la conversion. Et un domaine référent absent ne prouve pas que la visite n’avait aucune source. Ces trois notions sont souvent regroupées dans le même rapport d’acquisition, alors qu’elles décrivent des signaux différents :les paramètres UTM sont des étiquettes ajoutées volontairement à une URL ; le referrer est une information transmise par le navigateur dans certaines conditions ; le trafic direct est une catégorie utilisée lorsque l’outil ne dispose pas d’une source exploitable selon ses règles.Une lecture fiable commence par cette distinction. Elle se poursuit avec une nomenclature stable et une dose de prudence : l’attribution web est une reconstruction à partir de signaux incomplets, pas un relevé exhaustif du parcours d’une personne. Les UTM : une déclaration ajoutée au lien Un lien de campagne peut ressembler à ceci : https://www.example.com/guide/?utm_source=newsletter&utm_medium=email&utm_campaign=launch_juneLes paramètres les plus courants sont :utm_source : l’origine déclarée, par exemple linkedin, newsletter ou partner_name ; utm_medium : le type de canal, par exemple paid_social, email ou referral; utm_campaign : le nom de l’initiative ; utm_content : une variante de création, de placement ou de bouton ; utm_term : historiquement associé aux mots-clés, mais utilisable avec prudence selon le besoin.Google Analytics documente aussi d’autres paramètres manuels, mais une PME gagne rarement à multiplier les dimensions. Trois champs obligatoires et un champ de variante suffisent souvent. L’UTM n’est pas détecté automatiquement par le navigateur. Il est écrit par la personne ou le système qui produit le lien. Il faut donc le lire comme une déclaration de campagne, avec les forces et les faiblesses de toute donnée déclarative. Ce que les UTM font bien Ils sont utiles lorsque le referrer est absent, trop générique ou insuffisant :une newsletter ; un QR code ; un document PDF ; une signature d’email ; une publication sociale organique ou payante ; une campagne partenaire ; un lien dans une application.Ils permettent aussi de distinguer deux liens qui pointent vers la même page, par exemple le bouton principal et le lien de pied de newsletter. Ce qu’ils ne prouvent pas Un UTM ne prouve pas que la campagne a créé toute la demande. Il indique que la visite observée est arrivée avec cette étiquette. Le lien peut avoir été copié dans un canal privé, partagé par un collègue, ouvert plusieurs jours après sa réception ou modifié par un intermédiaire. Un utilisateur peut également avoir découvert la marque ailleurs avant de cliquer. C’est pourquoi le reporting doit parler de visites et conversions attribuées selon la règle de mesure, pas d’une causalité certaine. Le referrer : un signal transmis sous conditions Lorsqu’un navigateur suit un lien, il peut envoyer un en-tête HTTP Referer au site de destination. Malgré la faute historique dans le nom de l’en-tête, il s’agit du mécanisme qui permet souvent d’identifier le site précédent. La quantité d’information transmise dépend de la politique de referrer, du protocole, du navigateur, du contexte d’ouverture et des choix du site source. La politique par défaut moderne strict-origin-when-cross-origin transmet généralement :l’URL complète pour une navigation vers la même origine ; uniquement l’origine pour une navigation HTTPS entre origines ; aucune information lors d’une navigation d’un contexte HTTPS vers HTTP.Un site peut appliquer une politique plus stricte, une application peut ouvrir le lien dans une webview, et certaines redirections ou protections peuvent supprimer le signal. Le referrer est donc utile, mais jamais garanti. Referrer et UTM peuvent coexister Une visite peut fournir les deux :referrer : linkedin.com; utm_source : linkedin; utm_medium : paid_social; utm_campaign : webinar_june.L’outil analytics applique alors ses propres règles de priorité. Dans GA4, les paramètres manuels alimentent des dimensions spécifiques de source, support et campagne, tandis que les regroupements de canaux reposent sur des règles documentées et susceptibles d’évoluer. Le point opérationnel est simple : ne comparez pas deux rapports sans vérifier leur périmètre et leur scope. « Première source utilisateur », « source de session » et « source d’un événement clé » ne répondent pas à la même question. Le trafic direct est un manque de signal exploitable Dans le langage courant, « direct » évoque une personne qui saisit l’adresse ou utilise un favori. Ces comportements existent. Mais la catégorie peut aussi recevoir des visites dont la source a été perdue. Exemples fréquents :lien non marqué dans une application mobile ou une messagerie ; document local, PDF ou présentation ; redirection qui ne conserve pas les paramètres ; politique de referrer restrictive ; passage d’un environnement sécurisé vers un environnement moins sécurisé ; campagne email sans UTM ; lien copié puis partagé dans un canal privé ; erreur de déploiement ou de configuration analytics ; URL nettoyée avant que le script ne lise les paramètres.Il est donc plus juste d’interpréter « direct » comme :L’outil n’a pas attribué cette visite à une source plus précise avec les données disponibles.Une forte part de direct n’est pas automatiquement un problème. Elle devient un signal d’audit lorsqu’elle change brutalement, se concentre sur une page de campagne ou diffère fortement entre des outils censés observer le même périmètre. La méthode pour construire une nomenclature UTM stable Le principal risque n’est pas l’absence d’UTM. C’est une nomenclature incohérente qui fragmente les rapports. 1. Définir un vocabulaire fermé pour utm_medium Le support doit représenter une famille de canal. Limitez-le à une liste contrôlée, par exemple : email paid_search paid_social organic_social partner affiliate display offlineNe mélangez pas paid-social, paidsocial, cpc_social et social_paid. Les outils peuvent traiter les majuscules et variantes de manière différente, et vos tableaux les afficheront souvent comme des valeurs distinctes. 2. Nommer la source comme une plateforme ou un partenaire Exemples : linkedin google customer_newsletter partner_acme event_parisÉvitez de placer le nom de la campagne dans la source. Sinon, vous perdez la capacité à comparer un même canal dans le temps. 3. Donner à la campagne une structure lisible Une convention simple : objectif_offre_periodePar exemple : lead_demo_2026q2 launch_product_2026june retention_webinar_2026q3Choisissez une langue, une casse et un séparateur. Pour réduire les erreurs, les minuscules et les underscores sont faciles à contrôler. 4. Réserver utm_content aux variantes utiles Ce champ peut identifier :hero_button; footer_link; video_a; creative_02; partner_banner.Ne l’utilisez pas pour injecter des phrases ou des informations sur le destinataire. 5. Centraliser la génération Un tableur avec validation de données, un petit générateur interne ou un formulaire contrôlé évite la majorité des variantes. Chaque ligne doit contenir :URL de destination ; source ; medium ; campagne ; contenu éventuel ; propriétaire ; date de création ; statut actif ou archivé.Ne mettez jamais de donnée personnelle dans un UTM Les paramètres de requête circulent largement. Ils peuvent apparaître dans :l’historique du navigateur ; les logs du serveur et du CDN ; les outils analytics ; les outils de support ; les captures d’écran ; les liens copiés ; certains referrers ; les exports et rapports.N’utilisez donc pas d’adresse email, de nom, de numéro client, de téléphone, de jeton ou d’identifiant permettant de retrouver une personne. Cette règle vaut aussi pour des champs internes apparemment pratiques : utm_content=client_12345 utm_campaign=renewal_alice@example.comCes valeurs transforment un outil de campagne en vecteur de diffusion de données personnelles. Le bon niveau est une catégorie ou une variante de création, pas un individu. Votre data collection summary doit préciser quels paramètres sont autorisés, stockés ou supprimés. Cinq erreurs qui faussent les rapports Utiliser des UTM sur les liens internes Ajouter des UTM entre deux pages de son propre site peut créer une nouvelle attribution ou écraser le contexte précédent selon l’outil. Utilisez plutôt un événement ou une dimension interne lorsque vous devez comparer des emplacements de navigation. Marquer tous les liens externes sans hiérarchie Un UTM n’est pas nécessaire quand le referrer fournit déjà un signal suffisant et que vous n’avez aucune variante à distinguer. Le marquage doit servir une question, pas produire des colonnes supplémentaires. Changer de convention en cours de campagne linkedin, LinkedIn et linkedin.com deviennent facilement trois lignes. Corrigez la nomenclature à la source et conservez un journal des changements. Nettoyer l’URL trop tôt Il est légitime de retirer les paramètres visibles après leur lecture afin d’obtenir une URL propre. Mais si le code les supprime avant que le système de mesure ne les capture, la campagne tombe dans une autre catégorie. Testez l’ordre d’exécution. Comparer des outils sans aligner les règles Deux plateformes peuvent avoir des définitions de session, fenêtres d’attribution, listes de sources et règles de priorité différentes. Un écart ne signifie pas automatiquement qu’une des deux est défaillante. Diagnostiquer une hausse du trafic direct Procédez dans cet ordre. 1. Localiser la hausse Regardez les pages d’entrée, appareils, pays, heures et domaines concernés. Une hausse sur la page d’accueil n’a pas la même signification qu’une hausse sur une landing page accessible uniquement depuis une campagne. 2. Vérifier les déploiements Cherchez un changement de redirection, de routeur, de CMP, de tag manager, de script analytics ou de nettoyage d’URL. 3. Auditer les campagnes actives Ouvrez les liens réels des emails, publicités, profils sociaux, QR codes et documents. Ne vous contentez pas du tableur de préparation. 4. Tester le parcours complet Suivez le lien dans le contexte réel : application mobile, messagerie, navigateur intégré, PDF ou QR code. Observez la requête de collecte et le rapport final. 5. Accepter une part d’incertitude Le dark social et les contextes sans referrer ne peuvent pas être reconstruits avec certitude sans ajouter des mécanismes de suivi plus intrusifs. Une analytics responsable accepte parfois une catégorie résiduelle plutôt que de fabriquer une précision artificielle. Le tableau de bord minimal d’acquisition Pour une PME B2B, quatre vues suffisent souvent :sessions ou visites par source et medium ; pages d’entrée par source ; conversions utiles par source ; évolution du direct et de l’unassigned.Ajoutez le coût et le revenu seulement si leur définition est fiable et leur rapprochement documenté. Un ROAS précis en apparence mais construit sur des identifiants incomplets peut être moins utile qu’un coût par demande qualifiée bien défini. Analysez les tendances sur plusieurs semaines. Les volumes faibles rendent les variations journalières trompeuses. Conclusion Les UTM, le referrer et le trafic direct ne sont pas trois versions d’une même donnée. Ce sont trois mécanismes qui se complètent et se contredisent parfois. Une bonne pratique d’acquisition repose sur :une nomenclature UTM courte et contrôlée ; aucun identifiant personnel dans les URL ; une compréhension des limites du referrer ; une définition prudente du direct ; des règles d’attribution documentées ; des contrôles réguliers sur les liens réellement diffusés.L’objectif n’est pas de faire disparaître tout trafic direct. Il est de rendre les campagnes importantes lisibles sans prétendre reconstituer chaque parcours. FAQ Quelle différence entre utm_source et le referrer ? utm_source est une valeur ajoutée volontairement au lien. Le referrer est un signal que le navigateur peut transmettre à partir de la page précédente. Ils peuvent être présents ensemble ou séparément. Le trafic direct correspond-il aux personnes qui connaissent déjà la marque ? Parfois, mais pas uniquement. Il inclut aussi des visites pour lesquelles aucune source exploitable n’a été attribuée, par exemple depuis certaines applications, documents ou campagnes non marquées. Quels UTM sont vraiment nécessaires ? Pour la plupart des équipes, utm_source, utm_medium et utm_campaign forment le socle. utm_content est utile pour distinguer des variantes. Ajoutez d’autres paramètres seulement s’ils répondent à une question précise. Faut-il mettre des UTM sur les liens internes ? En général, non. Ils peuvent perturber l’attribution. Utilisez des événements ou dimensions dédiées pour mesurer la navigation interne. Peut-on supprimer les UTM de l’URL après l’arrivée ? Oui, après les avoir capturés correctement. Testez l’ordre d’exécution et conservez les informations uniquement selon votre politique de collecte et de conservation. SourcesGoogle Analytics, Traffic-source dimensions, manual tagging and auto-tagging Google Analytics, Default channel group definitions MDN, Referer header MDN, Referrer-Policy header OWASP, Information exposure through query strings in URL CNIL, Les six grands principes du RGPD
Lire l'article →
- 18 May, 2026
Data collection summary : documenter clairement ce que votre analytics collecte
Installer un outil analytics prend parfois quelques minutes. Expliquer précisément ce qu’il collecte peut prendre beaucoup plus longtemps. La difficulté ne vient pas seulement du volume de données. Elle vient de la dispersion de l’information. Une partie se trouve dans le plan de marquage, une autre dans la documentation du fournisseur, une autre dans le gestionnaire de consentement, et une dernière dans le code du site. Quand une question arrive, par exemple « transmettons-nous l’URL complète ? », « l’adresse IP est-elle stockée ? » ou « combien de temps gardons-nous les événements ? », personne ne dispose forcément d’une réponse complète. Un data collection summary est un document court qui rassemble ces réponses. Il décrit la collecte telle qu’elle fonctionne réellement, et non telle qu’on l’imagine à partir d’une page marketing. Ce n’est ni un avis juridique, ni un remplacement du registre des traitements, ni une politique de confidentialité. C’est une vue technique et opérationnelle qui relie les trois. À quoi sert un data collection summary ? Le document répond à une question simple :Pour chaque donnée ou signal collecté, savons-nous d’où il vient, pourquoi nous le collectons, où il va, combien de temps nous le gardons et qui peut y accéder ?Cette vue est utile à plusieurs équipes. L’équipe produit peut vérifier qu’un nouvel événement répond à un besoin réel. L’équipe marketing peut comprendre quelles dimensions sont disponibles sans supposer que « l’outil doit sûrement les avoir ». L’équipe technique dispose d’une référence pour les filtres, les transformations et les environnements. Le DPO ou le conseil juridique peut confronter la réalité technique aux documents de conformité. La direction peut enfin savoir quel risque et quelle dette accompagnent la mesure d’audience. Le RGPD impose notamment des principes de finalité, de minimisation, de transparence et de limitation de la conservation. Il prévoit aussi, selon les situations, une information des personnes et la tenue d’un registre des activités de traitement. Le data collection summary ne crée pas ces obligations, mais il facilite la production d’informations exactes et cohérentes. Ce document n’est pas le registre des traitements La distinction est importante. Le registre des activités de traitement est un document de gouvernance prévu par l’article 30 du RGPD dans les cas où il s’applique. Il décrit un traitement à un niveau relativement large : finalités, catégories de personnes, catégories de données, destinataires, transferts, durées et mesures de sécurité. Le data collection summary descend au niveau de l’implémentation. Il peut préciser que :l’URL est enregistrée sans la chaîne de requête ; l’adresse IP est utilisée brièvement pour une opération technique puis non conservée ; le user-agent est réduit à une famille de navigateur ; les paramètres utm_source, utm_medium et utm_campaign sont conservés ; un identifiant de formulaire n’est envoyé qu’après validation ; les données brutes et les rapports agrégés n’ont pas la même durée de conservation.La politique de confidentialité, elle, traduit les éléments pertinents dans un langage destiné aux visiteurs. Elle ne doit pas devenir une copie de la documentation technique, mais elle ne peut être fiable que si cette documentation existe. On peut donc résumer les rôles ainsi :Document Public principal Niveau de détail FonctionRegistre des traitements Interne, conformité Traitement et catégories Démontrer et piloter la conformitéData collection summary Interne, produit et technique Champs, flux et contrôles Décrire la collecte réellement déployéePolitique de confidentialité Visiteurs et utilisateurs Information claire Expliquer les traitements pertinents aux personnesPlan de marquage Produit, marketing, développement Événements et règles Définir ce qui doit être mesuréCes documents se complètent. Ils ne doivent pas se contredire. Les 10 colonnes d’un résumé utile Un tableur suffit. L’important est la qualité des colonnes et la discipline de mise à jour. 1. Donnée ou signal Nommez la donnée sans jargon commercial : chemin de page, domaine référent, type d’appareil, événement de formulaire, identifiant de site, paramètre UTM, pays dérivé, adresse IP temporaire. Évitez les catégories vagues comme « données techniques ». Elles masquent les choix concrets. 2. Exemple de valeur Un exemple réduit les ambiguïtés. Pour un chemin de page : /tarifs/. Pour une source : newsletter. Pour un événement : demo_requested. N’utilisez pas de vraie donnée personnelle dans le document. Un exemple synthétique suffit. 3. Source Précisez où le signal apparaît : navigateur, serveur, formulaire, CMS, CDN, script analytics ou import externe. Cette colonne aide à repérer les données collectées indirectement. Un outil peut, par exemple, recevoir une URL ou un en-tête avant même que votre code de tracking ne les transforme. 4. Finalité opérationnelle Écrivez une phrase qui relie la donnée à une décision : « mesurer les pages d’entrée qui génèrent une demande de démonstration » est plus utile que « analyse marketing ». Une finalité trop large est un signal d’alerte. Si une donnée sert supposément à tout, son besoin n’est probablement pas assez défini. 5. Transformation avant stockage Indiquez ce qui est supprimé, tronqué, agrégé ou dérivé :suppression des paramètres non autorisés ; normalisation du chemin ; réduction du user-agent ; géolocalisation approximative puis suppression de l’adresse IP ; hachage d’un identifiant, avec la précision qu’un hachage n’est pas automatiquement une anonymisation ; agrégation quotidienne ou mensuelle.Cette colonne permet de distinguer ce que le système reçoit de ce qu’il conserve. 6. Destination et sous-traitants Listez les systèmes qui reçoivent la donnée : endpoint de collecte, stockage brut, base agrégée, outil de BI, export, fournisseur cloud ou prestataire analytics. Ajoutez la région d’hébergement et les transferts pertinents lorsqu’ils sont connus et documentés. Ne déduisez pas la localisation juridique d’un simple nom de région cloud. 7. Durée de conservation Séparez les couches lorsque nécessaire :logs techniques ; événements bruts ; données pseudonymisées ; statistiques agrégées ; sauvegardes ; exports manuels.Une seule durée globale est souvent trompeuse. La CNIL rappelle que la durée doit être déterminée selon la finalité et limitée au nécessaire. Pour les traceurs de mesure d’audience susceptibles d’entrer dans le cadre d’une exemption en France, elle recommande notamment une durée de vie de treize mois pour les traceurs et une conservation des informations collectées limitée à vingt-cinq mois. Ces repères ne dispensent pas d’analyser la configuration réelle. 8. Accès Décrivez les rôles, pas seulement les noms : administrateurs, analystes, agence, support, prestataire d’hébergement. Précisez si l’accès porte sur les rapports agrégés, les événements bruts ou les exports. « L’équipe marketing a accès » est insuffisant si un compte générique permet aussi de télécharger toutes les données. 9. Dépendance au consentement ou à la configuration Cette colonne doit rester factuelle. Indiquez par exemple :collecté uniquement après signal de consentement ; désactivé en mode de mesure stricte ; activé uniquement pour certaines campagnes ; soumis à une analyse locale ePrivacy ; utilisé pour une mesure d’audience limitée, sous réserve que toutes les conditions applicables soient remplies.N’écrivez pas simplement « exempté » sans documenter les conditions, le périmètre et la configuration. 10. Suppression et responsable Enfin, indiquez comment la donnée disparaît et qui vérifie le processus : suppression automatique, tâche planifiée, purge fournisseur, procédure manuelle, échéance de contrat, suppression d’un export. Ajoutez un propriétaire interne et une date de dernière revue. Sans responsable, le document vieillit dès la prochaine mise en production. Exemple minimal pour une PME SaaS Voici un extrait volontairement simplifié :Signal Finalité Traitement avant stockage Conservation AccèsChemin de page Mesurer les contenus consultés Query string supprimée, chemin normalisé 25 mois pour les rapports Produit, marketingDomaine référent Comprendre les sources de visite Origine uniquement lorsque transmise 25 mois Marketingutm_source Identifier une campagne déclarée Valeurs normalisées selon une nomenclature 25 mois MarketingÉvénement demo_requested Mesurer une conversion B2B Aucun contenu de formulaire envoyé 25 mois Produit, ventes en agrégéAdresse IP Sécurité et dérivation géographique approximative Utilisée temporairement, non stockée dans l’événement Durée technique documentée Opérations restreintesUser-agent Répartition technique Réduit à une catégorie de navigateur et appareil 25 mois ProduitCe tableau ne prouve rien à lui seul. Il doit correspondre au réseau observé, au code et aux réglages du fournisseur. C’est pourquoi il est utile de commencer par un audit des traceurs effectivement chargés et de comparer le résultat au plan de marquage minimaliste. Méthode de construction en cinq étapes Étape 1 : partir du trafic réseau Ouvrez les outils de développement du navigateur, rechargez les pages représentatives et observez les requêtes. Faites le test avant et après chaque choix de consentement, sur plusieurs parcours et appareils. Relevez les domaines, les payloads, les paramètres d’URL et les événements. Le réseau montre ce qui est transmis depuis le navigateur. Il ne montre pas nécessairement toutes les transformations côté serveur, mais il constitue un point de départ vérifiable. Étape 2 : lire le code et la configuration Inspectez le script de collecte, le gestionnaire de tags, les règles du CMP, les variables d’environnement et les filtres. Une documentation fournisseur générique ne dit pas quelle option votre site a activée. Vérifiez également les fonctionnalités annexes : enregistrement de session, enrichissement publicitaire, export vers une régie, connexion CRM ou identifiants utilisateurs. Étape 3 : interroger le fournisseur avec des questions fermées Demandez des réponses vérifiables :l’URL complète est-elle reçue et stockée ? les paramètres de requête sont-ils filtrables avant stockage ? l’adresse IP est-elle journalisée ailleurs que dans les événements ? quelles sauvegardes contiennent encore les données après suppression ? le fournisseur réutilise-t-il les données pour son propre compte ? quels sous-traitants et transferts sont concernés ? les exports obéissent-ils à la même politique de conservation ?Une réponse « privacy-friendly » ne remplit aucune colonne. Étape 4 : confronter les documents Comparez le résumé technique au registre, au contrat de sous-traitance, à la politique de confidentialité et au bandeau de consentement. Les incohérences sont plus importantes que la qualité littéraire de chaque document pris séparément. Exemple classique : la politique affirme que seules des statistiques agrégées sont collectées, alors que le gestionnaire de tags envoie un identifiant utilisateur à un outil tiers. Étape 5 : instaurer une revue liée aux changements Le document doit être revu lors de toute modification significative :nouvel outil ; nouvel événement ; changement de domaine de collecte ; activation d’un export ; nouvelle durée de conservation ; modification du consentement ; changement de sous-traitant ; ajout d’une propriété ou d’un site.Une revue trimestrielle légère permet aussi de détecter les écarts silencieux. Les erreurs qui rendent le document inutile Copier la documentation commerciale La documentation du fournisseur décrit un produit possible. Votre résumé doit décrire votre instance, vos options et vos flux. Confondre pseudonymisation et anonymisation Un identifiant haché ou rotatif peut rester une donnée personnelle s’il permet encore de distinguer ou relier une personne. Utilisez des termes précis et documentez le risque de réidentification. Oublier les URL Les URL complètes peuvent contenir des emails, identifiants de commande, termes de recherche interne ou jetons. Même un outil conçu pour collecter peu peut recevoir une donnée excessive si le site place cette donnée dans l’adresse. Ne documenter que le tableau de bord Le rapport visible n’est qu’une surface. Les logs, exports, événements bruts, sauvegardes et intégrations comptent aussi. Laisser le document sans propriétaire Une fiche parfaite mais non maintenue devient rapidement plus dangereuse qu’une fiche absente, car elle donne une confiance injustifiée. Checklist de validation Avant d’approuver le résumé, vérifiez que :chaque donnée a une finalité spécifique ; les données reçues et les données stockées sont distinguées ; les paramètres d’URL et champs libres ont été audités ; les durées sont définies par couche ; les destinataires et accès sont nommés ; le consentement et les modes de configuration sont explicités ; la suppression est testable ; le contenu concorde avec les documents publics et contractuels ; un responsable et une date de revue sont indiqués ; toute affirmation d’anonymisation est techniquement justifiée.Conclusion Un data collection summary n’est pas un document de plus à ranger dans un dossier conformité. C’est une interface commune entre produit, marketing, technique et juridique. Sa valeur vient de sa précision. Une équipe qui sait exactement ce qu’elle collecte peut supprimer les données inutiles, expliquer les données utiles, configurer correctement ses outils et répondre plus vite aux questions internes ou externes. Commencez par une seule propriété web et les dix signaux les plus importants. Vérifiez-les dans le réseau et le code, puis élargissez seulement si la collecte réelle le justifie. FAQ Le data collection summary est-il obligatoire au titre du RGPD ? Ce format précis n’est pas imposé par le RGPD. Il peut toutefois aider à produire et maintenir des documents obligatoires ou nécessaires, notamment le registre des traitements et l’information des personnes. Faut-il publier ce document ? Pas nécessairement. Il contient souvent des détails techniques internes. Les informations pertinentes pour les personnes doivent être reprises clairement dans la politique de confidentialité ou d’autres notices appropriées. Une adresse IP non stockée doit-elle apparaître ? Oui si elle est reçue ou utilisée, même brièvement. Le résumé doit distinguer réception, traitement temporaire, transformation et stockage. Peut-on utiliser le même résumé pour plusieurs sites ? Seulement si les flux et configurations sont réellement identiques. Pour un environnement multi-sites, gardez un socle commun et documentez les écarts par propriété. À quelle fréquence faut-il le mettre à jour ? À chaque changement significatif de collecte ou de destination, avec une revue périodique. Une vérification trimestrielle est un rythme pratique pour une petite équipe, sans constituer une règle juridique universelle. SourcesRèglement (UE) 2016/679, notamment articles 5, 13, 25 et 30 CNIL, Le registre des activités de traitement CNIL, Cookies : solutions pour les outils de mesure d’audience CEPD, Lignes directrices 4/2019 sur la protection des données dès la conception et par défaut Chrome for Developers, Network features reference OWASP, Information exposure through query strings in URL
Audit des traceurs d’un site web : la checklist pratique pour une PME
Un audit de traceurs ne consiste pas à compter les cookies affichés dans un navigateur puis à produire une capture d’écran. L’objectif est plus utile : comprendre quels composants communiquent avec quels services, à quel moment, pour quelle finalité et avec quelles données. Cette distinction est importante. Un site peut ne déposer aucun cookie et envoyer malgré tout des informations à des tiers. À l’inverse, un cookie peut être strictement nécessaire au fonctionnement demandé par l’utilisateur. Le mot « cookie » ne suffit donc pas à qualifier le risque, la finalité ou le régime applicable. Pour une PME, un SaaS B2B ou une équipe qui gère plusieurs sites, le bon livrable n’est pas un rapport de cinquante pages. C’est un inventaire vérifiable, relié à des responsables, à des décisions et à un plan d’action. Avant de commencer, gardez une limite claire en tête : un audit technique n’est pas un avis juridique. Il fournit les faits nécessaires pour documenter la configuration et décider avec les personnes compétentes. Ce que l’audit doit permettre de répondre À la fin de l’exercice, l’équipe devrait pouvoir répondre sans approximation à huit questions :Quels scripts, pixels, SDK et ressources tierces sont chargés ? Quels cookies, stockages locaux ou identifiants sont créés ? Quelles requêtes partent avant le choix de l’utilisateur ? Quelles données apparaissent dans les URL, en-têtes et corps de requête ? Quel fournisseur reçoit chaque information ? Quelle finalité opérationnelle justifie chaque composant ? Combien de temps les données et identifiants sont-ils conservés ? Qui peut accéder aux données, les exporter ou modifier la configuration ?Cette grille évite un piège fréquent : auditer uniquement la bannière, sans vérifier ce que le site fait réellement. La CNIL rappelle que la notion de traceur est technologiquement large. Elle couvre notamment les cookies HTTP, pixels, stockages locaux et certaines techniques d’empreinte. L’absence de cookie visible n’est donc pas une preuve suffisante d’absence de traçage. Préparer un périmètre représentatif Un audit réalisé uniquement sur la page d’accueil est rarement concluant. Les composants varient selon les pages, les parcours et l’état de consentement. Construisez un échantillon qui couvre au minimum :la page d’accueil ; une page de contenu ; une page produit ou service ; une page de tarification ; un formulaire ; une page de confirmation ; un espace authentifié, s’il existe ; une page intégrant une vidéo, une carte, un chat ou un outil de prise de rendez-vous ; une URL de campagne avec paramètres UTM ; les versions linguistiques ou domaines principaux dans un environnement multi-sites.Testez aussi plusieurs états :nouvelle visite sans choix enregistré ; refus de tous les traceurs optionnels ; acceptation sélective ; acceptation globale ; retour avec un choix déjà mémorisé ; navigation privée ou profil navigateur vierge.Pour les pages sensibles, ajoutez un scénario spécifique. Un espace client, une page de santé, un formulaire RH ou une console d’administration ne doit pas être traité comme une simple page éditoriale. La méthode d’audit en sept étapes 1. Partir d’un navigateur propre Utilisez un profil navigateur vierge, sans extension susceptible de bloquer ou réécrire les requêtes. Ouvrez les outils de développement avant de charger la page et activez la conservation du journal réseau. Notez précisément :l’URL testée ; la date ; le navigateur et sa version ; le scénario de consentement ; l’environnement, production ou préproduction ; l’identité de la personne qui a réalisé le test.Cette traçabilité rend l’audit reproductible. Elle permet aussi de comparer un résultat avant et après correction. 2. Inventorier les composants chargés Dans l’onglet Réseau, filtrez successivement les requêtes de type script, image, fetch, XHR et document. Relevez les domaines tiers ainsi que les fichiers chargés depuis votre propre domaine mais fournis par un prestataire. Un script servi en first party n’est pas nécessairement maîtrisé en interne. Un proxy, un gestionnaire de tags ou un CDN peut masquer l’origine fonctionnelle du composant. Pour chaque entrée, enregistrez :Champ Exemple de questionComposant Quel script ou service est chargé ?Propriétaire Quelle équipe l’a demandé ?Fournisseur Qui opère le service ?Finalité Mesure, support, sécurité, publicité, vidéo ?Déclenchement Avant choix, après acceptation, à l’action ?Données observées URL, referrer, IP, identifiant, événement ?Destination Domaine et région de traitement connues ?Action Conserver, configurer, différer ou supprimer ?Ne vous contentez pas du nom commercial. Un même fournisseur peut proposer plusieurs produits avec des comportements très différents. 3. Vérifier les stockages côté navigateur Inspectez :les cookies first party et third party ; localStorage ; sessionStorage ; IndexedDB ; les service workers ; les caches applicatifs lorsque c’est pertinent.Pour chaque cookie ou clé, relevez son nom, son domaine, sa durée, ses attributs et le moment où il apparaît. Les attributs Secure, HttpOnly et SameSite donnent des indications de sécurité, mais ils ne déterminent pas à eux seuls la finalité ou le besoin de consentement. Supprimez les données de site entre les scénarios. Sinon, un identifiant posé pendant un test « acceptation » peut fausser le test « refus ». 4. Comparer les déclenchements avant et après le choix C’est l’étape qui révèle les erreurs de configuration les plus concrètes. Rechargez la même page dans chaque état et comparez :les domaines contactés ; le nombre de requêtes ; les cookies créés ; les événements envoyés ; les scripts différés ; les appels déclenchés par une interaction.Un tag peut être absent au premier chargement puis se déclencher au scroll, au clic ou à l’ouverture d’un composant. Testez donc les interactions principales, pas seulement le chargement initial. Pour les outils de session replay, de chat ou de personnalisation, vérifiez aussi le masquage et les zones exclues. Le plan de marquage minimaliste constitue un bon point de comparaison : une collecte utile doit rester reliée à une décision, pas à la possibilité technique de tout enregistrer. 5. Inspecter les données réellement transmises Ouvrez plusieurs requêtes et examinez :l’URL complète ; les paramètres de requête ; le corps de la requête ; les en-têtes ; le referrer ; les identifiants persistants ; les propriétés d’événement.Cherchez en priorité les données qui ne devraient jamais circuler dans une URL analytics :adresse e-mail ; numéro de téléphone ; nom ; identifiant client ; jeton de réinitialisation ; token de session ; contenu libre d’un formulaire ; requête de recherche sensible ; référence de dossier.Les URL sont souvent copiées dans les journaux, historiques, outils de monitoring et systèmes de support. Une donnée placée dans la query string peut donc se propager bien au-delà de l’outil analytics. 6. Relier la technique à la gouvernance L’onglet Réseau ne vous dira pas tout. Complétez l’audit avec la documentation fournisseur et les paramètres du compte :durée de conservation ; localisation et sous-traitants ; transferts éventuels ; réutilisation des données par le fournisseur ; options de partage ; rôles et accès ; exports ; suppression ; journaux d’audit ; configuration multi-sites.Pour une mesure d’audience susceptible d’entrer dans un cadre sans consentement en France, la configuration réelle compte. La CNIL exige notamment une finalité strictement limitée à la mesure pour le compte de l’éditeur et des statistiques anonymes, sans recoupement ni suivi global entre sites. Notre décryptage du cadre CNIL détaille ces conditions et leurs limites. 7. Transformer l’inventaire en plan d’action Classez les constats selon quatre niveaux simples :Critique : donnée sensible ou identifiant exposé, tag marketing déclenché malgré un refus, token présent dans une URL. Élevé : fournisseur inconnu, absence de propriétaire, session replay sur une zone sensible, rétention non maîtrisée. Moyen : durée excessive, doublon de tags, paramètre inutile, documentation incomplète. Faible : optimisation de nommage, nettoyage de test, amélioration d’un commentaire ou d’une preuve.Chaque action doit avoir un responsable, une échéance et un test de validation. « À revoir » n’est pas une action exploitable. Un audit rapide en 90 minutes Pour un site simple, une première passe peut tenir dans un atelier court : 20 minutes : cartographier Listez les pages critiques, les outils attendus et les états de consentement. 30 minutes : observer Inspectez réseau et stockage sur trois à cinq pages, en état initial, refus et acceptation. 20 minutes : rapprocher Comparez les domaines observés avec la bannière, la politique de confidentialité, le gestionnaire de tags et les contrats fournisseurs. 20 minutes : décider Supprimez les composants sans propriétaire, créez les tickets prioritaires et planifiez les tests plus profonds. Cette passe ne remplace pas un audit complet, mais elle détecte souvent les écarts les plus coûteux : scripts oubliés, tags en double, données personnelles dans les URL et déclenchements trop précoces. Les erreurs fréquentes Confondre inventaire automatique et conclusion Un scanner aide à découvrir des domaines et cookies. Il ne connaît pas toujours la finalité, le contexte d’un événement ou la configuration contractuelle. Son résultat doit être vérifié manuellement. Ne tester que l’acceptation globale Le scénario le plus important est souvent celui du refus. Il permet de vérifier que les choix sont réellement respectés. Ignorer les requêtes first party Le fait qu’une requête parte vers votre domaine ne garantit pas qu’elle reste dans votre infrastructure ni qu’elle ne contienne pas de données indésirables. Auditer la production une seule fois Un gestionnaire de tags, une intégration marketing ou un changement de CMS peut modifier la collecte sans changement visible de l’interface. Un contrôle trimestriel léger et un audit avant les lancements importants sont plus utiles qu’un grand exercice ponctuel. Produire un tableau sans propriétaire Un inventaire sans décision, responsable ni date devient rapidement obsolète. La gouvernance est ce qui transforme l’audit en réduction de risque. Le livrable minimal à conserver Conservez quatre éléments :le tableau d’inventaire ; les preuves principales, captures ou exports réseau ; le registre des décisions, avec justification ; la liste des actions et le résultat des retests.Versionnez le document. Pour une équipe multi-sites, ajoutez une colonne « propriété web » et séparez ce qui est commun de ce qui varie localement. Conclusion L’objectif n’est pas de déclarer le site parfait. Il est de pouvoir expliquer, à une date donnée, ce qui a été observé, pourquoi chaque composant existe et comment les écarts sont traités. FAQ Un site sans cookies a-t-il besoin d’un audit de traceurs ? Oui. Des pixels, requêtes réseau, stockages locaux ou techniques d’identification peuvent fonctionner sans cookie HTTP. L’audit doit porter sur les échanges et les finalités, pas uniquement sur la liste des cookies. Les outils de scan automatique suffisent-ils ? Non. Ils accélèrent l’inventaire, mais ne remplacent pas la vérification manuelle des déclenchements, des données envoyées, des paramètres de compte et des responsabilités internes. Faut-il auditer chaque page du site ? Pas nécessairement. Il faut sélectionner un échantillon représentatif des gabarits, intégrations, parcours et états de consentement, puis approfondir les zones sensibles. À quelle fréquence refaire l’audit ? Après toute modification importante de la stack, avant un lancement sensible et selon un rythme régulier adapté au volume de changements. Pour une petite équipe, une revue trimestrielle légère est souvent plus réaliste qu’un audit annuel massif. Un audit technique prouve-t-il la conformité RGPD ? Non. Il documente les faits techniques et facilite l’analyse. La conformité dépend aussi des finalités, bases juridiques, contrats, informations fournies, droits des personnes et règles nationales applicables. Sources Sources vérifiées le 21 juin 2026.CNIL, « Cookies et traceurs : que dit la loi ? » CNIL, « Cookies : solutions pour les outils de mesure d’audience » CNIL, consultation sur le rejeu de session, 25 février 2026 EDPB, Guidelines 2/2023 on the technical scope of Article 5(3) of the ePrivacy Directive Chrome for Developers, Network panel reference OWASP, Information exposure through query strings in URL
- 04 May, 2026
Session replay et CNIL : ce que les équipes doivent vérifier après la consultation 2026
Le 25 février 2026, la CNIL a ouvert une consultation publique sur un projet de recommandation consacré aux outils de session replay. La consultation s'est clôturée le 22 avril 2026. À la date de publication de cet article, les équipes doivent donc traiter ce projet comme un signal de cadrage fort, tout en suivant la publication de la recommandation finale. Les outils de session replay ne sont pas de simples solutions de mesure d'audience. Ils peuvent enregistrer des interactions détaillées : défilement, clics, comportement de formulaire, hésitations dans l'interface et parfois du contenu saisi si le masquage est incomplet. Ce niveau de détail crée un profil de risque différent de celui de statistiques de trafic agrégées. La conséquence pratique est simple : les équipes produit, marketing et support ne devraient pas activer le session replay comme une option de tableau de bord anodine. Il faut un objectif documenté, des réglages de minimisation, du masquage, un contrôle d'accès, une durée de conservation courte et une décision claire sur les conditions dans lesquelles l'enregistrement est autorisé. Pourquoi le session replay est sensible Le session replay peut aider à diagnostiquer des bugs, des formulaires bloquants ou des parcours difficiles à comprendre. Mais un enregistrement peut aussi révéler des données personnelles, des champs sensibles, un contexte de compte ou des comportements que l'équipe n'avait pas prévu de collecter. Une configuration trop large peut donc capter davantage d'informations que nécessaire. C'est pour cette raison que le projet de recommandation de la CNIL insiste sur la proportionnalité et les garanties. La bonne question n'est pas de savoir si un outil est populaire. Elle est de vérifier si votre configuration limite réellement ce qui est capté, qui peut le consulter et combien de temps l'information reste disponible. Checklist de lancement Avant d'activer un outil de session replay, passez en revue ces points :définissez l'objectif exact : diagnostic UX, investigation support, contrôle qualité ou autre besoin documenté ; désactivez l'enregistrement par défaut sur les pages sensibles et les espaces authentifiés, sauf justification validée ; masquez les champs de formulaire, les zones de texte libre, les données de compte et tout champ susceptible de contenir une donnée personnelle ou sensible ; limitez l'échantillon de sessions enregistrées plutôt que d'enregistrer toutes les visites ; réservez l'accès à des rôles nommés et auditez les consultations ; fixez une durée de conservation courte et supprimez les enregistrements quand le besoin opérationnel disparaît ; documentez l'outil, le fournisseur, les transferts et la conservation dans vos supports privacy ; vérifiez que l'état d'enregistrement respecte votre dispositif de consentement ou de gestion des préférences ; conservez une procédure de rollback pour couper rapidement l'enregistrement en cas de fuite ou de pic anormal.Différence avec l'analytics Pomelo Le positionnement de Pomelo est volontairement différent. Le modèle par défaut est cookieless, minimal et orienté reporting. Il sert à répondre à des questions opérationnelles avec des données agrégées, pas à rejouer des parcours individuels. Cette distinction compte. Le session replay peut être utile dans un workflow de diagnostic limité, mais il ne doit pas être confondu avec une mesure d'audience privacy-first. Pour la plupart des PME, SaaS B2B et équipes multi-sites, la base analytics doit rester plus légère qu'un outil d'enregistrement. Que faire maintenant Si vous utilisez déjà Hotjar, Microsoft Clarity, FullStory ou un outil similaire, lancez un audit court avant le prochain cycle de mise en production :listez les pages où l'enregistrement est actif ; inspectez les vingt derniers enregistrements pour détecter une capture accidentelle de données personnelles ; revoyez les règles de masquage avec un interlocuteur non technique ; confirmez la conservation et les contrôles d'accès ; décidez si l'outil est nécessaire en continu ou seulement pendant des fenêtres de recherche limitées.Si l'équipe ne peut pas expliquer pourquoi les enregistrements sont nécessaires, il est préférable de les désactiver jusqu'à ce que l'objectif et les garanties soient documentés. Sources Sources vérifiées le 9 mai 2026.CNIL, "Rejeu de session : la CNIL lance une consultation publique sur son projet de recommandation", 25 février 2026 CNIL, "Cookies et autres traceurs : la CNIL publie des recommandations pour les outils de mesure d'audience" Hotjar, "Privacy and security" Microsoft Clarity, "Privacy overview"
- 27 Apr, 2026
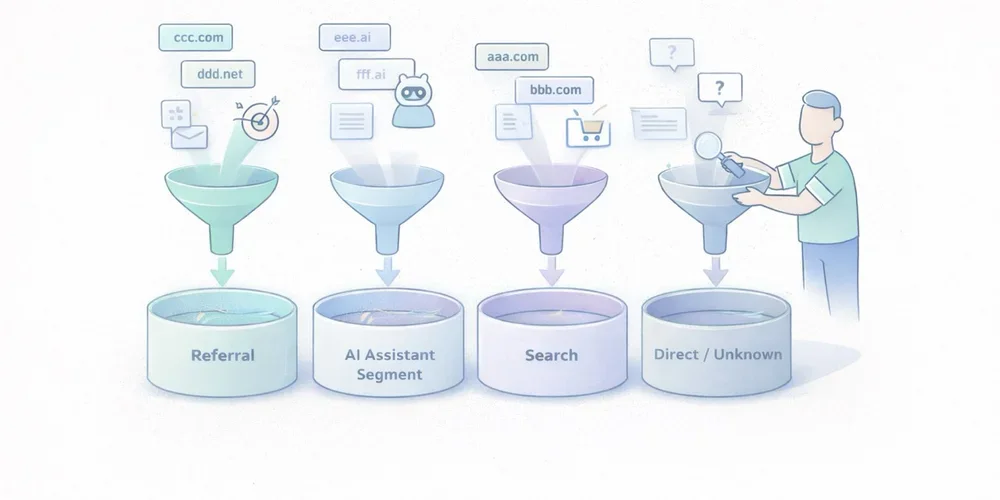
Le trafic des assistants IA n’est pas du trafic direct : comment mesurer ChatGPT, Perplexity et Claude sans vous raconter d’histoires
Depuis quelques mois, beaucoup d’équipes marketing voient apparaître la même discussion : “On reçoit du trafic IA maintenant, non ?” La question est légitime. ChatGPT, Perplexity, Claude et d’autres interfaces affichent de plus en plus de liens vers des sites web. Certaines équipes commencent à voir passer ces visites dans leurs dashboards. D’autres regardent leur trafic direct monter et en concluent que “les IA envoient du direct”. Le problème est que cette lecture mélange plusieurs réalités. Une partie du trafic issu des assistants IA est mesurable comme du referral classique. Une autre partie se perd dans le direct ou unknown parce qu’aucun referrer exploitable n’est transmis. Une troisième partie n’existe tout simplement pas dans vos analytics, parce qu’il n’y a eu aucun clic. Et quand Google intègre des expériences IA dans Search, la frontière devient encore moins nette. Autrement dit, le trafic IA n’est ni un nouveau canal parfaitement propre, ni une simple illusion. C’est un ensemble hétérogène qu’il faut lire avec méthode. Le bon objectif n’est pas de tout mesurer parfaitement. Le bon objectif est plus modeste et plus utile : isoler ce qui est réellement attribuable, documenter la zone grise, et éviter de raconter des histoires à partir d’un chiffre fragile. Le trafic IA n’est pas une seule source Le premier point à clarifier est simple : “trafic IA” n’est pas une catégorie technique unique. Dans la pratique, on mélange au moins quatre cas différents. 1. Les assistants qui envoient un vrai referrer Certains usages de ChatGPT, Perplexity ou Claude affichent des liens vers des sources web. Quand l’utilisateur clique depuis une interface qui transmet une information de provenance exploitable, votre outil analytics peut voir un domaine référent. C’est la partie la plus simple à mesurer. Elle ressemble à n’importe quel trafic referral :une visite arrive avec un domaine source identifiable ; une landing page est consultée ; l’utilisateur peut ensuite convertir, rebondir, ou poursuivre sa navigation.Ce cas suffit déjà à justifier un segment dédié. Plausible a par exemple documenté une forte hausse de son trafic de referral issu de ChatGPT, Perplexity, Claude et Phind en 2024. Ce n’est pas une statistique universelle, mais c’est un signal utile : les assistants IA peuvent envoyer un trafic visible et exploitable. 2. Les assistants ou apps qui ne transmettent pas correctement la provenance Tous les clics ne remontent pas proprement. La documentation de Fathom rappelle d’ailleurs qu’une visite en “Direct/unknown” peut venir d’un accès direct, d’un email, d’une app, ou d’un cas où aucun referrer n’a été transmis, et qu’aucun outil analytics ne peut contrôler cela. C’est là que beaucoup d’équipes se trompent. Voir monter le direct ne prouve pas que ce trafic vient des assistants IA. Mais l’inverse est aussi vrai : une partie du trafic issu des assistants IA peut se retrouver absorbée dans le direct ou unknown si le contexte technique ne renvoie pas d’information exploitable. 3. Les réponses IA qui citent votre site sans générer de clic C’est un point crucial. Vous pouvez être cité, résumé, utilisé comme source, voire partiellement consommé dans la réponse de l’assistant, sans qu’aucune visite n’arrive sur votre site. Dans ce cas, vos analytics web ne voient rien. Vous avez peut-être gagné en visibilité. Vous n’avez pas gagné de session. Confondre les deux mène très vite à de faux raisonnements. 4. Les expériences IA intégrées à la recherche classique Le cas Google est particulier. Google présente AI Overviews et AI Mode comme des fonctionnalités de Search qui peuvent afficher des liens vers des sites et qui ne demandent pas d’optimisation SEO séparée des fondamentaux habituels. Pour la mesure, cela veut dire une chose simple : tout ce qui relève de l’IA n’apparaît pas forcément comme un canal distinct, surtout quand l’expérience reste intégrée à un environnement de recherche déjà existant. Il faut donc éviter une logique trop binaire du type :“assistant autonome = trafic IA” ; “moteur de recherche = trafic SEO classique”.Dans la réalité, la frontière devient plus poreuse. Ce que vous pouvez réellement mesurer aujourd’hui La bonne nouvelle, c’est que vous pouvez déjà mesurer plusieurs choses utiles sans instrumentation extravagante. Les domaines référents visibles C’est la base. Si votre outil analytics expose les referrers ou les sources, vous pouvez identifier les visites attribuées à des domaines liés aux assistants IA. Selon votre stack, cela peut passer par :un rapport Referrers ; un rapport Sources ; un segment personnalisé ; un channel group dédié.Google Analytics 4 donne même un exemple explicite de groupe de canaux personnalisé “AI assistants”, avec des correspondances pour des assistants comme ChatGPT, Gemini, Copilot, Claude ou Perplexity. C’est une information importante. Elle montre qu’en 2026, même Google Analytics considère ce regroupement comme un cas d’usage légitime, pas comme une lubie marketing. Les landing pages qui captent ces visites Le volume seul sert rarement à grand-chose. La vraie question est : quelles pages attirent ce trafic ? Si trois articles, deux pages produit et une page comparative captent l’essentiel des visites issues des assistants IA, vous avez déjà une première lecture exploitable :quelles ressources sont citées ou reprises ; quels sujets émergent ; quelles pages jouent un rôle d’entrée ; quels contenus méritent une amélioration.C’est souvent plus utile qu’un chiffre global de sessions. Les conversions et signaux d’intention Si votre outil suit les événements ou les objectifs, vous pouvez aller plus loin :demande de démo ; inscription newsletter ; prise de rendez-vous ; essai démarré ; achat ; clic vers une page pricing ou un CTA stratégique.À ce stade, vous ne mesurez plus seulement de la curiosité. Vous commencez à mesurer la qualité du trafic. C’est là qu’un segment “AI assistants” devient intéressant. Non pas pour produire un effet de mode, mais pour comparer :volume ; taux d’engagement ; profondeur de visite ; conversion.Les campagnes UTM quand vous contrôlez vous-même la distribution Il y a aussi un cas plus simple : celui des liens que vous diffusez. Si vous publiez un contenu dans une newsletter, un document, un partenariat ou un répertoire, et que vous voulez observer son éventuelle reprise par des usages liés aux assistants ou aux moteurs enrichis, les UTM restent utiles pour vos propres campagnes. En revanche, il ne faut pas imaginer que les assistants IA vont spontanément préserver vos conventions de tracking dans tous les contextes. Les UTM sont excellents pour suivre ce que vous distribuez volontairement. Ils sont beaucoup moins fiables pour cartographier l’ensemble des citations et clics générés par des systèmes tiers. Ce que vous ne pourrez pas mesurer proprement C’est souvent la partie la plus importante de l’article. Une bonne mesure commence aussi par accepter ses limites. Vous ne verrez pas les mentions sans clic Si un assistant résume votre contenu, répond avec vos idées, ou vous cite sans déclencher de visite, vos analytics web resteront muets. Cela ne veut pas dire que votre contenu ne joue aucun rôle. Cela veut juste dire que la session web n’est pas le bon capteur pour mesurer cette forme de visibilité. Vous ne séparerez pas toujours proprement le trafic IA du direct Quand une visite arrive sans referrer exploitable, vous entrez dans une zone grise. Cette zone peut contenir :du vrai direct ; de l’email ; des messageries ; des apps ; des navigateurs ou contextes qui coupent la provenance ; potentiellement des usages issus d’assistants IA.La seule posture sérieuse consiste à le reconnaître comme une zone d’incertitude. Pas à lui coller une étiquette certaine. Vous ne pourrez pas attribuer parfaitement les expériences IA de recherche Quand une expérience IA reste intégrée à un moteur déjà existant, l’attribution isolée devient plus compliquée. Google explique que ses fonctionnalités IA dans Search s’inscrivent dans le cadre général de la recherche web, avec les mêmes fondamentaux SEO. Pour une équipe marketing, cela implique une lecture prudente : toute visite issue d’un environnement enrichi par l’IA ne sera pas forcément identifiable comme telle dans vos rapports. Vous ne devez pas confondre citation, visite et revenu Être cité dans un assistant, recevoir un clic, obtenir une session engagée et générer une conversion sont quatre niveaux différents. Un dashboard utile doit garder ces niveaux séparés. Sinon, on passe très vite d’un constat modeste, “on a quelques visites depuis ChatGPT et Perplexity”, à un récit beaucoup trop ambitieux, “l’IA devient notre nouveau canal d’acquisition principal”. La méthode la plus propre pour suivre ce trafic L’objectif n’est pas de construire un système parfait. L’objectif est de mettre en place une lecture simple, stable et réutilisable. 1. Créez un segment ou un canal dédié aux assistants IA Commencez par une liste courte de sources réellement observables. Par exemple :ChatGPT / OpenAI ; Perplexity ; Claude / Anthropic ; éventuellement Copilot ou Gemini si vous les voyez apparaître dans vos données.Restez conservateur. N’ajoutez pas dix domaines hypothétiques que vous ne voyez jamais passer. 2. Analysez d’abord les landing pages Avant de commenter le volume, regardez :quelles pages reçoivent ces visites ; si ces pages sont récentes ou anciennes ; si elles répondent à des questions comparatives, explicatives ou pratiques ; si elles sont adaptées à une lecture d’entrée.C’est souvent ici que les enseignements utiles apparaissent. 3. Comparez la qualité du trafic, pas seulement son volume Un trafic faible mais très qualifié peut être plus intéressant qu’un trafic visible mais creux. Comparez au minimum :le temps ou l’engagement disponible dans votre outil ; la profondeur de visite ; les conversions principales ; les CTA cliqués ; les pages de sortie.4. Gardez un œil séparé sur le direct ou unknown Il ne faut pas fusionner le direct avec les assistants IA. Mais il serait naïf de l’ignorer complètement. La bonne approche consiste à documenter ce point comme une zone grise potentielle. Si vos referrers IA visibles augmentent, et que le direct augmente aussi sur les mêmes landing pages, cela peut justifier une hypothèse. Pas une certitude. 5. Documentez la règle de lecture C’est un détail qui change tout dans les équipes. Écrivez noir sur blanc :quels domaines sont inclus dans le segment IA ; ce qui n’est pas mesuré ; ce qui tombe en direct ou unknown ; quelles conversions sont suivies ; à quelle fréquence vous relisez ce segment.Un bon dashboard ne suffit pas. Il faut aussi une convention d’interprétation. Les erreurs les plus fréquentes Appeler “trafic IA” tout ce qui ressemble à une hausse du direct C’est probablement l’erreur la plus courante. Le direct est un agrégat imparfait. Il peut contenir beaucoup de choses. Lui attribuer une cause unique sans preuve dégrade la qualité de la lecture. Créer un canal trop large dès le départ Si vous regroupez n’importe quel domaine vaguement lié à l’IA, vous fabriquez un segment imprécis. Mieux vaut un segment incomplet mais propre qu’un segment large et douteux. Se focaliser sur le volume avant la conversion Recevoir 500 visites peu engagées depuis une interface IA est moins intéressant que recevoir 30 visites vers une page comparative qui convertit. Mélanger SEO classique, assistants IA et trafic de marque sans méthode La bonne logique n’est pas de tout opposer. C’est de distinguer ce qui est observable, ce qui est comparable, et ce qui reste hypothétique. Ce qu’il faut retenir Le trafic des assistants IA existe. Il n’est pas imaginaire. Mais il n’existe pas non plus sous une forme unique, propre et parfaitement attribuable. Une partie arrive comme du referral visible. Une partie se perd dans le direct ou unknown. Une partie ne produira jamais de session parce qu’il n’y aura pas de clic. Et une partie s’inscrit dans des environnements de recherche où l’IA et le search classique deviennent plus difficiles à séparer. La bonne approche tient en quatre règles simples :isolez les referrers réellement visibles ; mesurez les landing pages et les conversions, pas seulement les sessions ; gardez le direct comme zone grise, pas comme vérité cachée ; documentez clairement ce que votre segment IA contient, et ce qu’il ne contient pas.Ce cadre est moins spectaculaire qu’une promesse de mesure totale. Il est aussi beaucoup plus utile. FAQ Le trafic venant de ChatGPT doit-il être classé en direct ? Non, pas par principe. Quand un referrer exploitable est transmis, il peut être mesuré comme du referral ou rangé dans un segment dédié. Mais une partie des visites peut aussi finir en direct ou unknown selon le contexte technique. Peut-on mesurer les citations sans clic dans les assistants IA ? Pas avec une analytics web classique. Sans session ni clic, votre outil de mesure d’audience ne voit rien. Faut-il créer un canal IA séparé dans GA4 ? Oui, si vous commencez à voir des domaines référents liés à des assistants IA. GA4 prévoit d’ailleurs ce cas dans sa documentation sur les groupes de canaux personnalisés. Le trafic IA doit-il être lu comme un nouveau canal d’acquisition majeur ? Pas automatiquement. Il faut d’abord regarder les landing pages, la qualité du trafic et les conversions avant de conclure. Peut-on distinguer parfaitement Google Search classique et ses expériences IA ? Pas toujours. Quand l’IA est intégrée à une expérience de recherche plus large, l’attribution isolée devient plus délicate. SourcesOpenAI Help Center, ChatGPT search : https://help.openai.com/en/articles/9237897-chatgpt-search Claude Help Center, Using Research on Claude : https://support.claude.com/en/articles/11088861-using-research-on-claude Perplexity Help Center, How does Perplexity work? : https://www.perplexity.ai/help-center/en/articles/10352895-how-does-perplexity-work Google Analytics Help, Custom channel groups : https://support.google.com/analytics/answer/13051316 Google Search Central, AI features and your website : https://developers.google.com/search/docs/appearance/ai-features Fathom Analytics Docs, Dashboard explained : https://usefathom.com/docs/start/dashboard Plausible Analytics, Breaking down our AI traffic surge : https://plausible.io/blog/ai-referral-traffic-and-optimization