Catégorie : Privacy engineering
Tous les articles du blog dans cette catégorie.
- 21 Sep, 2026
Données anonymes, pseudonymisées ou agrégées : ce que les lignes directrices 2026 du CEPD changent pour l’analytics
Dans les produits analytics, les mots « anonyme », « anonymisé », « pseudonymisé », « agrégé » et « hashé » sont souvent utilisés trop vite. Ils donnent une impression de sécurité, mais ils ne décrivent pas toujours la même réalité juridique ou technique. Le sujet revient au premier plan en 2026. Le Comité européen de la protection des données a adopté des lignes directrices sur l’anonymisation, soumises à consultation publique jusqu’au 30 octobre 2026. Le texte vise à clarifier ce qu’est une donnée anonyme et à intégrer la jurisprudence récente de la Cour de justice de l’Union européenne. Pour les équipes analytics, c’est une occasion de revoir les claims et les architectures. Une donnée n’est pas anonyme parce qu’elle ne contient plus de nom. Une adresse IP tronquée, un identifiant hashé ou une statistique agrégée peuvent réduire le risque, mais ne suffisent pas toujours à sortir du champ des données personnelles. Pourquoi le sujet est stratégique pour l’analytics Un outil analytics collecte rarement un seul type de signal. Même lorsqu’il est privacy-first, il peut traiter des URL, des referrers, des paramètres de campagne, des horodatages, des pays, des appareils, des événements, des parcours ou des pages vues rares. Pris isolément, chaque signal peut sembler peu sensible. Ensemble, ils peuvent parfois rendre une personne ou un comportement reconnaissable, surtout dans des petits volumes : une page consultée par une seule personne, un segment très spécifique, une conversion rare, une requête contenant une donnée personnelle, ou un lien de campagne avec un identifiant. La question n’est donc pas seulement : « collectons-nous des identifiants directs ? ». La question est : un acteur disposant de moyens raisonnablement susceptibles d’être utilisés peut-il encore relier cette information à une personne, qui serait alors identifiable directement ou indirectement ? Anonyme, pseudonymisé, agrégé : trois niveaux différents Une donnée pseudonymisée remplace ou masque certains identifiants, mais un lien peut encore exister avec une personne. Un hash, un identifiant stable ou une clé séparée peuvent rester des données personnelles si un rapprochement est possible. Une donnée agrégée regroupe plusieurs observations. Elle réduit souvent le risque, mais elle ne garantit pas automatiquement l’anonymat. Une statistique sur un segment de très petite taille peut révéler une information sur une personne ou un petit groupe. Une donnée anonyme ne se rapporte plus à une personne identifiée ou identifiable. C’est un seuil exigeant. Il ne suffit pas de supprimer les noms visibles. Il faut regarder les moyens raisonnablement disponibles, les possibilités de recoupement et le contexte de l’acteur qui détient ou reçoit les données. Pour un blog ou une page produit, la prudence consiste à réserver le mot « anonyme » aux situations réellement testées. Dans les autres cas, des formulations comme « collecte minimale », « agrégation », « absence d’identifiant persistant » ou « réduction du risque de réidentification » sont souvent plus exactes. Les trois risques à tester Les méthodes d’anonymisation sont généralement évaluées à travers trois familles de risques. 1. Isolement Peut-on isoler un enregistrement ou un comportement unique dans le jeu de données ? Exemple analytics : une page interne très peu visitée reçoit une seule visite depuis un pays donné, sur un créneau horaire précis. Même sans nom, l’observation peut être très distinctive. 2. Corrélation ou liaison Peut-on relier plusieurs enregistrements entre eux ou avec une autre source ? Exemple analytics : un identifiant hashé est utilisé dans plusieurs exports, ou une combinaison pays + appareil + referrer + URL permet de retrouver le même visiteur dans plusieurs tableaux. 3. Inférence Peut-on déduire une information nouvelle sur une personne ou un petit groupe ? Exemple analytics : un segment « visiteurs de la page tarifs entreprise depuis le domaine d’un prospect précis » peut révéler une intention commerciale si les volumes sont trop faibles. Ces risques ne sont pas binaires. Ils dépendent du contexte, de la granularité, de l’accès aux données brutes, des autres informations disponibles et des personnes qui consultent les rapports. Ce que cela change dans un setup analytics Le premier changement est lexical. Les équipes devraient éviter d’appeler « anonymes » des données simplement parce qu’elles sont cookieless ou parce qu’un identifiant direct est absent. Cookieless ne signifie pas automatiquement anonyme. Le deuxième changement est architectural. L’anonymisation ne se juge pas seulement à la collecte. Elle se juge à chaque étape : collecte, prétraitement, stockage, agrégation, exposition dans les dashboards, export, API et suppression. Le troisième changement est documentaire. Si une organisation affirme que certaines données sont anonymes, elle doit pouvoir expliquer pourquoi. Quelles colonnes restent disponibles ? Quelles combinaisons ont été testées ? Quels seuils empêchent les petits segments ? Qui peut accéder aux données brutes ? Combien de temps sont-elles conservées ? Exemple : les URL et paramètres de campagne Les URL sont un bon exemple de risque sous-estimé. Une page consultée peut révéler une information métier. Un paramètre d’URL peut contenir un email, un identifiant CRM, un token de confirmation, une clé de campagne ou un numéro client. Même dans un outil sans cookies, enregistrer l’URL complète sans filtrage peut créer une collecte accidentelle de données personnelles. L’anonymisation ne corrigera pas toujours le problème si la donnée sensible est stockée en clair avant traitement. La meilleure approche consiste à agir en amont :filtrer ou supprimer les paramètres à risque ; conserver les paramètres utiles à l’attribution sous forme contrôlée ; documenter les règles de filtrage ; éviter les exports bruts non nécessaires ; appliquer des seuils d’affichage sur les petits volumes.Exemple : les rapports multi-sites Les tableaux de bord multi-sites ajoutent un autre risque. Ils agrègent souvent des données provenant de plusieurs domaines, marques, pays ou entités. Cette consolidation est utile pour la gouvernance, mais elle peut aussi rendre certains comportements plus repérables si les volumes sont faibles. Un responsable global n’a pas toujours besoin de voir chaque combinaison site + page + pays + appareil + heure. Un tableau de bord mature adapte la granularité au rôle : synthèse pour la direction, détails pour l’équipe opérationnelle, accès restreint aux données sensibles. L’anonymisation n’est donc pas seulement un traitement technique. C’est aussi une question de droits d’accès et de design du reporting. Checklist d’audit Pour auditer vos claims et votre architecture analytics, vérifiez :les données brutes sont-elles encore accessibles ? les URL complètes sont-elles stockées ? les paramètres d’URL à risque sont-ils filtrés avant stockage ? des identifiants stables, même hashés, sont-ils utilisés ? les petits segments sont-ils masqués ou regroupés ? les exports contiennent-ils plus de détails que le dashboard ? les durées de conservation sont-elles justifiées ? les droits d’accès sont-ils alignés avec le besoin réel ? les claims marketing utilisent-ils le bon vocabulaire ? l’équipe sait-elle expliquer pourquoi une donnée serait considérée comme anonyme ?Comment participer ou utiliser la consultation La consultation publique du CEPD est ouverte jusqu’au 30 octobre 2026. Toutes les équipes ne vont pas soumettre une contribution, mais toutes peuvent utiliser ce calendrier comme déclencheur d’audit. Un bon exercice consiste à créer un « résumé de collecte » : liste des données collectées, finalités, transformations, niveaux de granularité, durées de conservation, accès, exports, et formulation publique associée. L’objectif n’est pas de prouver que tout est anonyme. L’objectif est d’être exact. Un outil peut être privacy-first sans prétendre que chaque donnée est anonyme à chaque étape. Conclusion Les lignes directrices 2026 du CEPD rappellent une idée simple : l’anonymisation n’est pas un mot magique. C’est un résultat à démontrer dans un contexte donné. Pour l’analytics, cette clarification est saine. Elle encourage les équipes à réduire la collecte, limiter la granularité, filtrer les données accidentelles, contrôler les exports et choisir des formulations plus précises. La crédibilité privacy ne vient pas d’un vocabulaire maximaliste. Elle vient d’une architecture cohérente et d’une documentation honnête. FAQ Une donnée hashée est-elle anonyme ? Pas par défaut. Le hachage peut être utile, mais il ne supprime pas automatiquement l’identifiabilité si la valeur peut être retrouvée, devinée ou recoupée avec d’autres données. Un rapport analytics agrégé est-il toujours anonyme ? Non. L’agrégation réduit le risque, mais de petits segments, des événements rares ou des combinaisons inhabituelles peuvent encore révéler une information. La question utile est de savoir si une réidentification reste raisonnablement possible dans le contexte. Pourquoi la consultation compte pour l’analytics web ? Parce que les éditeurs et clients analytics utilisent souvent les mots anonyme, pseudonymisé et agrégé. Le projet du CEPD fournit une meilleure grille pour tester ces affirmations. SourcesCEPD - Guidelines 02/2026 on Anonymisation, consultation publique CEPD - EDPB sheds light on anonymisation and web scraping for generative AI CEPD - Public consultations
- 01 Jun, 2026
Quels paramètres d’URL filtrer dans une analytics privacy-first ?
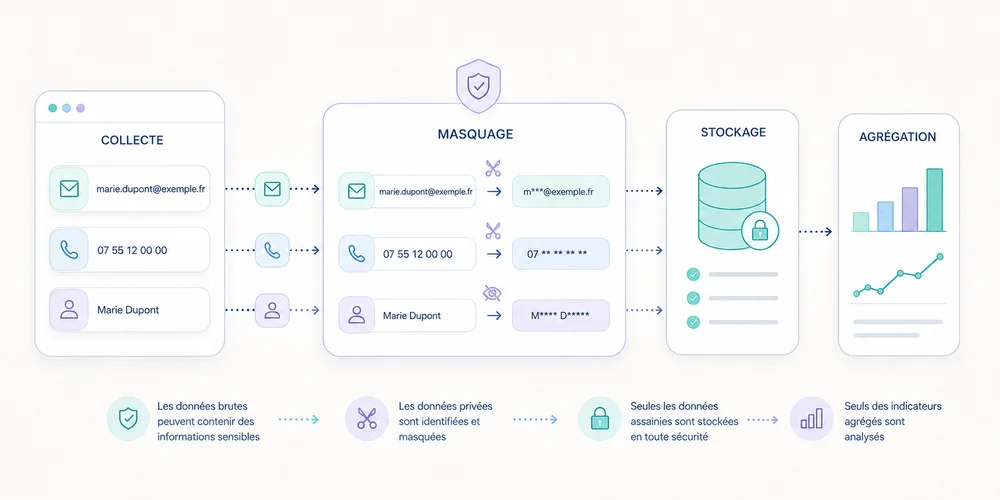
Une URL peut sembler anodine tout en transportant beaucoup plus d’information que le chemin de la page. https://example.com/confirmation? email=alice@example.com& order_id=84721& utm_source=newsletter& session_token=abc123Si un outil analytics collecte l’URL complète, ces valeurs peuvent se retrouver dans les événements, les logs, les exports, les captures d’écran et les rapports partagés. Le problème ne vient pas seulement de l’outil. Il commence souvent dans l’application, qui place une information excessive dans l’adresse. Une approche privacy-first traite le sujet à deux niveaux :ne pas mettre de donnée sensible ou personnelle dans l’URL ; ne transmettre à l’analytics que les paramètres explicitement utiles.Le filtre n’est donc pas une rustine unique. C’est un contrôle de défense en profondeur. Pourquoi les query parameters demandent un traitement spécifique La partie située après ? s’appelle la chaîne de requête. Elle contient des paires clé-valeur séparées par &. Ces paramètres peuvent servir à :attribuer une campagne ; paginer ou trier une liste ; sélectionner une langue ; préremplir un formulaire ; identifier une ressource ; transporter un jeton ; suivre une expérience ; mémoriser un filtre de recherche.Le navigateur, le serveur, le CDN, les outils de supervision et les scripts tiers peuvent tous observer une partie de l’URL. OWASP rappelle que des informations sensibles placées dans la query string peuvent apparaître dans l’historique, les journaux, les systèmes intermédiaires et parfois les en-têtes de provenance, même lorsque la connexion utilise HTTPS. HTTPS protège le transport entre deux points. Il ne rend pas le contenu de l’URL invisible aux systèmes autorisés qui la traitent. La règle principale : autoriser, plutôt que tenter de tout bloquer Une blocklist énumère les paramètres interdits : email phone token user_idElle échoue dès qu’un développeur introduit customer_email, invitee, auth ou une clé inconnue. Une allowlist énumère les paramètres dont l’usage analytics a été justifié : utm_source utm_medium utm_campaign utm_contentTout le reste est supprimé avant transmission ou stockage. L’allowlist est généralement plus robuste pour une collecte minimale. Elle réduit aussi la fragmentation des rapports : /produits/?sort=price, /produits/?sort=name et /produits/?session=xyz peuvent être regroupés sous un chemin stable lorsque ces variantes ne répondent à aucune question de pilotage. Il existe toutefois des applications où certains paramètres fonctionnels doivent rester visibles. La bonne méthode n’est pas « supprimer tout ce qui suit ? », mais classer chaque famille. Une grille de décision en six catégories 1. Paramètres de campagne autorisés Exemples : utm_source utm_medium utm_campaign utm_contentIls peuvent être utiles pour lire l’acquisition, à condition d’appliquer une nomenclature contrôlée et de ne jamais y placer d’identifiant personnel. Le guide sur les UTM, referrers et trafic direct détaille ces règles. Décision possible :collecter une liste courte ; normaliser la casse et les valeurs ; séparer les dimensions de campagne du chemin de page ; supprimer les paramètres de l’URL affichée après capture si cela ne casse pas le parcours.2. Paramètres fonctionnels sans intérêt analytique Exemples : sort view page theme currencyIls peuvent être nécessaires à l’interface sans mériter une dimension analytics. Les garder dans le rapport « pages » crée souvent des centaines de lignes. Décision possible :ne pas les envoyer dans l’URL de page ; mesurer un événement dédié si une décision produit dépend réellement du tri ou de la vue ; conserver seulement une catégorie réduite, par exemple filter_applied, sans recopier la valeur libre.3. Paramètres de contenu potentiellement utiles Exemples : lang category plan variantLeur utilité dépend du modèle de données. Avant de les autoriser, posez trois questions :cette valeur change-t-elle la décision ? existe-t-il une liste fermée de valeurs ? peut-elle contenir du texte saisi ou un identifiant ?Si les réponses sont favorables, transformez le paramètre en dimension contrôlée. Sinon, retirez-le. 4. Identifiants métier Exemples : order_id invoice customer ticket workspaceIls permettent souvent de relier une visite à un dossier, une commande ou un compte. Même lorsqu’ils ne contiennent pas un nom, ils peuvent devenir des données personnelles par recoupement. Décision recommandée :ne pas les transmettre à l’analytics généraliste ; mesurer une catégorie ou un statut agrégé ; traiter les besoins de diagnostic dans un système opérationnel séparé, avec des accès et une rétention adaptés.5. Données personnelles ou texte libre Exemples : email name phone address search messageLe texte libre est particulièrement risqué. Un champ de recherche interne peut contenir un nom, un problème médical, une adresse ou une phrase confidentielle. Décision recommandée :empêcher la donnée d’entrer dans l’URL ; la supprimer du payload analytics ; vérifier aussi les logs et outils tiers ; ne mesurer, si nécessaire, qu’une catégorie ou la présence d’une recherche.6. Secrets et jetons Exemples : token code jwt signature password_reset inviteCes valeurs ne doivent pas être capturées. Elles peuvent donner accès à une action ou à une ressource. Décision recommandée :revoir le design du parcours ; utiliser des jetons à durée courte et usage limité quand l’URL est techniquement nécessaire ; éviter leur journalisation ; supprimer le paramètre de l’adresse dès que possible ; exclure entièrement les pages concernées de l’analytics si le contrôle n’est pas fiable.Filtrer au bon endroit Niveau 1 : dans l’application La meilleure protection consiste à ne pas construire d’URL excessive. Ne préremplissez pas un formulaire avec une adresse email en clair dans la query string. Ne mettez pas un identifiant client dans un lien marketing. Ne copiez pas une recherche libre dans le titre de page. Ce niveau réduit l’exposition dans tous les systèmes, pas seulement l’analytics. Niveau 2 : avant l’envoi analytics Construisez une représentation nettoyée de la page : const current = new URL(window.location.href); const allowed = new Set([ "utm_source", "utm_medium", "utm_campaign", "utm_content", ]);const clean = new URL(current.origin + current.pathname);for (const [key, value] of current.searchParams) { if (allowed.has(key)) { clean.searchParams.set(key, value.toLowerCase().slice(0, 100)); } }const analyticsPage = clean.pathname; const campaign = Object.fromEntries(clean.searchParams);Cet exemple illustre le principe, pas une implémentation universelle. Il faut aussi :gérer les paramètres répétés ; valider les valeurs ; définir une longueur maximale ; refuser le texte libre ; tester les caractères encodés ; tenir compte du routeur de l’application ; vérifier que les erreurs ne font pas revenir à l’URL brute.Le plus sûr est souvent d’envoyer le chemin et les dimensions de campagne dans des champs séparés. Niveau 3 : dans le collecteur ou le proxy Un filtre côté serveur protège contre une erreur du navigateur ou un ancien script. Il peut rejeter les champs non autorisés, tronquer les valeurs et journaliser uniquement un code d’erreur sans recopier la donnée rejetée. Cette couche est essentielle si plusieurs sites ou équipes utilisent le même endpoint. Niveau 4 : dans l’outil analytics Certains outils fournissent des contrôles de redaction ou d’exclusion. GA4 propose notamment une fonction de redaction des emails et de paramètres de requête définis par l’administrateur. Matomo permet d’exclure des paramètres d’URL des rapports de pages. Ces réglages sont utiles, mais ils ne remplacent pas les contrôles précédents. Une donnée peut avoir traversé un tag manager, un log ou un proxy avant d’être masquée dans le rapport. Niveau 5 : dans les exports Un export historique peut conserver des valeurs qui ont ensuite été filtrées dans l’outil. La procédure doit inclure les entrepôts, sauvegardes, fichiers CSV et connecteurs de BI. Votre data collection summary doit distinguer ce qui est reçu, transformé, stocké et exposé. Normaliser les pages sans perdre l’information utile Un rapport de contenu doit généralement regrouper les variantes qui représentent la même ressource. Exemple : /products?sort=price&page=1 /products?sort=name&page=1 /products?utm_source=newsletter /products?session=abcLa dimension principale peut rester : /productsLes éléments utiles sont envoyés séparément : campaign_source=newsletter sort_used=trueCette structure produit des rapports plus lisibles et évite que des dimensions à forte cardinalité consomment inutilement les capacités de l’outil. Attention aux routes où le paramètre définit réellement le contenu Sur certaines architectures, ?article=42 ou ?category=security identifie la ressource. Supprimer le paramètre sans remplacement fusionnerait des pages différentes. Deux solutions :migrer vers des chemins stables, par exemple /articles/42; dériver un identifiant de contenu non personnel et contrôlé dans une dimension dédiée.Ne conservez pas automatiquement l’identifiant brut. Demandez d’abord s’il peut être relié à une personne ou à un dossier. SEO et analytics : deux nettoyages différents Le filtrage analytics et la gestion SEO des paramètres se recoupent, mais ne sont pas identiques. Pour le SEO, une équipe peut utiliser des URL canoniques, des redirections, des règles d’indexation et une structure de liens cohérente. Pour l’analytics, elle choisit la représentation utilisée dans les rapports. Une balise canonique n’empêche pas un script de collecter l’URL complète. Inversement, supprimer un paramètre du rapport analytics ne change pas la manière dont un moteur explore le site. Documentez les deux décisions séparément. Le protocole de test Test 1 : corpus de paramètres Créez une liste d’URL de test couvrant :UTM autorisés ; paramètre inconnu ; email encodé ; identifiant numérique ; valeur très longue ; paramètre répété ; caractères spéciaux ; token factice ; texte de recherche.Test 2 : observation réseau Dans les outils développeur, vérifiez le payload exact envoyé par le navigateur. Recherchez la valeur sensible factice dans toutes les requêtes, pas seulement celle de l’analytics principal. Test 3 : logs et stockage Vérifiez le collecteur, le CDN, les erreurs applicatives et les données brutes. Le fait qu’une valeur n’apparaisse pas dans le tableau de bord ne prouve pas qu’elle n’a jamais été stockée. Test 4 : rapports et exports Contrôlez les rapports pages, les dimensions personnalisées, l’API et un export représentatif. Test 5 : comportement en erreur Désactivez une règle, envoyez une clé inconnue et simulez un payload invalide. Le système doit échouer en mode sûr, sans enregistrer l’URL complète dans un message d’erreur. Gouverner l’allowlist dans le temps Conservez un petit registre avec :Paramètre Statut Finalité Valeurs autorisées Propriétaire Date de revueutm_source Autorisé Acquisition Taxonomie marketing Growth Trimestrielleutm_medium Autorisé Canal Liste fermée Growth Trimestriellelang Dérivé Contenu fr, en Produit Semestrielleemail Interdit Aucune Aucune Engineering Permanentetoken Interdit Sécurité Aucune Security PermanenteToute nouvelle clé doit passer par la même question : quelle décision justifie sa collecte ? Pour un environnement multi-sites, appliquez une allowlist commune par défaut et n’autorisez une exception que si elle est documentée pour la propriété concernée. Conclusion Le bon filtre n’est pas une longue liste de mots interdits. C’est une politique simple :aucune donnée personnelle ou secret dans l’URL ; une allowlist courte pour les signaux de campagne réellement utiles ; des dimensions contrôlées pour les besoins produit ; un nettoyage avant envoi et une validation côté serveur ; des tests sur le réseau, les logs, le stockage et les exports.Cette approche améliore simultanément la privacy, la sécurité et la lisibilité des rapports. Mesurer moins de variantes produit souvent une meilleure compréhension des pages qui comptent. FAQ Faut-il supprimer toute la query string des rapports analytics ? C’est une bonne valeur par défaut pour la dimension page, mais certaines applications utilisent des paramètres pour définir le contenu. Dans ce cas, dérivez une dimension contrôlée plutôt que de conserver l’URL brute. Les paramètres UTM peuvent-ils contenir une adresse email ? Non. Une adresse email dans une URL peut circuler dans de nombreux systèmes. Utilisez des catégories de campagne, jamais des identifiants de personnes. La redaction de GA4 suffit-elle ? Elle réduit certains risques dans GA4, mais ne couvre pas nécessairement les logs, autres tags, proxies ou exports. Filtrez le plus tôt possible et vérifiez toutes les couches. Un identifiant haché peut-il rester dans l’URL ? Le hachage ne rend pas automatiquement une valeur anonyme. Si l’identifiant permet de distinguer, relier ou retrouver une personne, il peut rester une donnée personnelle et ne devrait pas être transmis sans justification. Comment traiter les termes de recherche interne ? Évitez d’envoyer le texte libre. Mesurez plutôt l’usage de la recherche, une catégorie contrôlée ou des statistiques agrégées, après analyse du besoin. SourcesOWASP, Information exposure through query strings in URL MDN, URLSearchParams Google Analytics, Data redaction Matomo, Exclude URL query parameters from tracked URLs Règlement (UE) 2016/679, article 25 et principes de l’article 5 CEPD, Lignes directrices sur la protection des données dès la conception et par défaut